Как я делал пет-проект используя только Промто и вариант "безлимит".
Как я делал ЧОПТО на ПРОМТО: один человек, несколько месяцев и ни одного потраченного нейрокредита
Что за пет-проект я делал
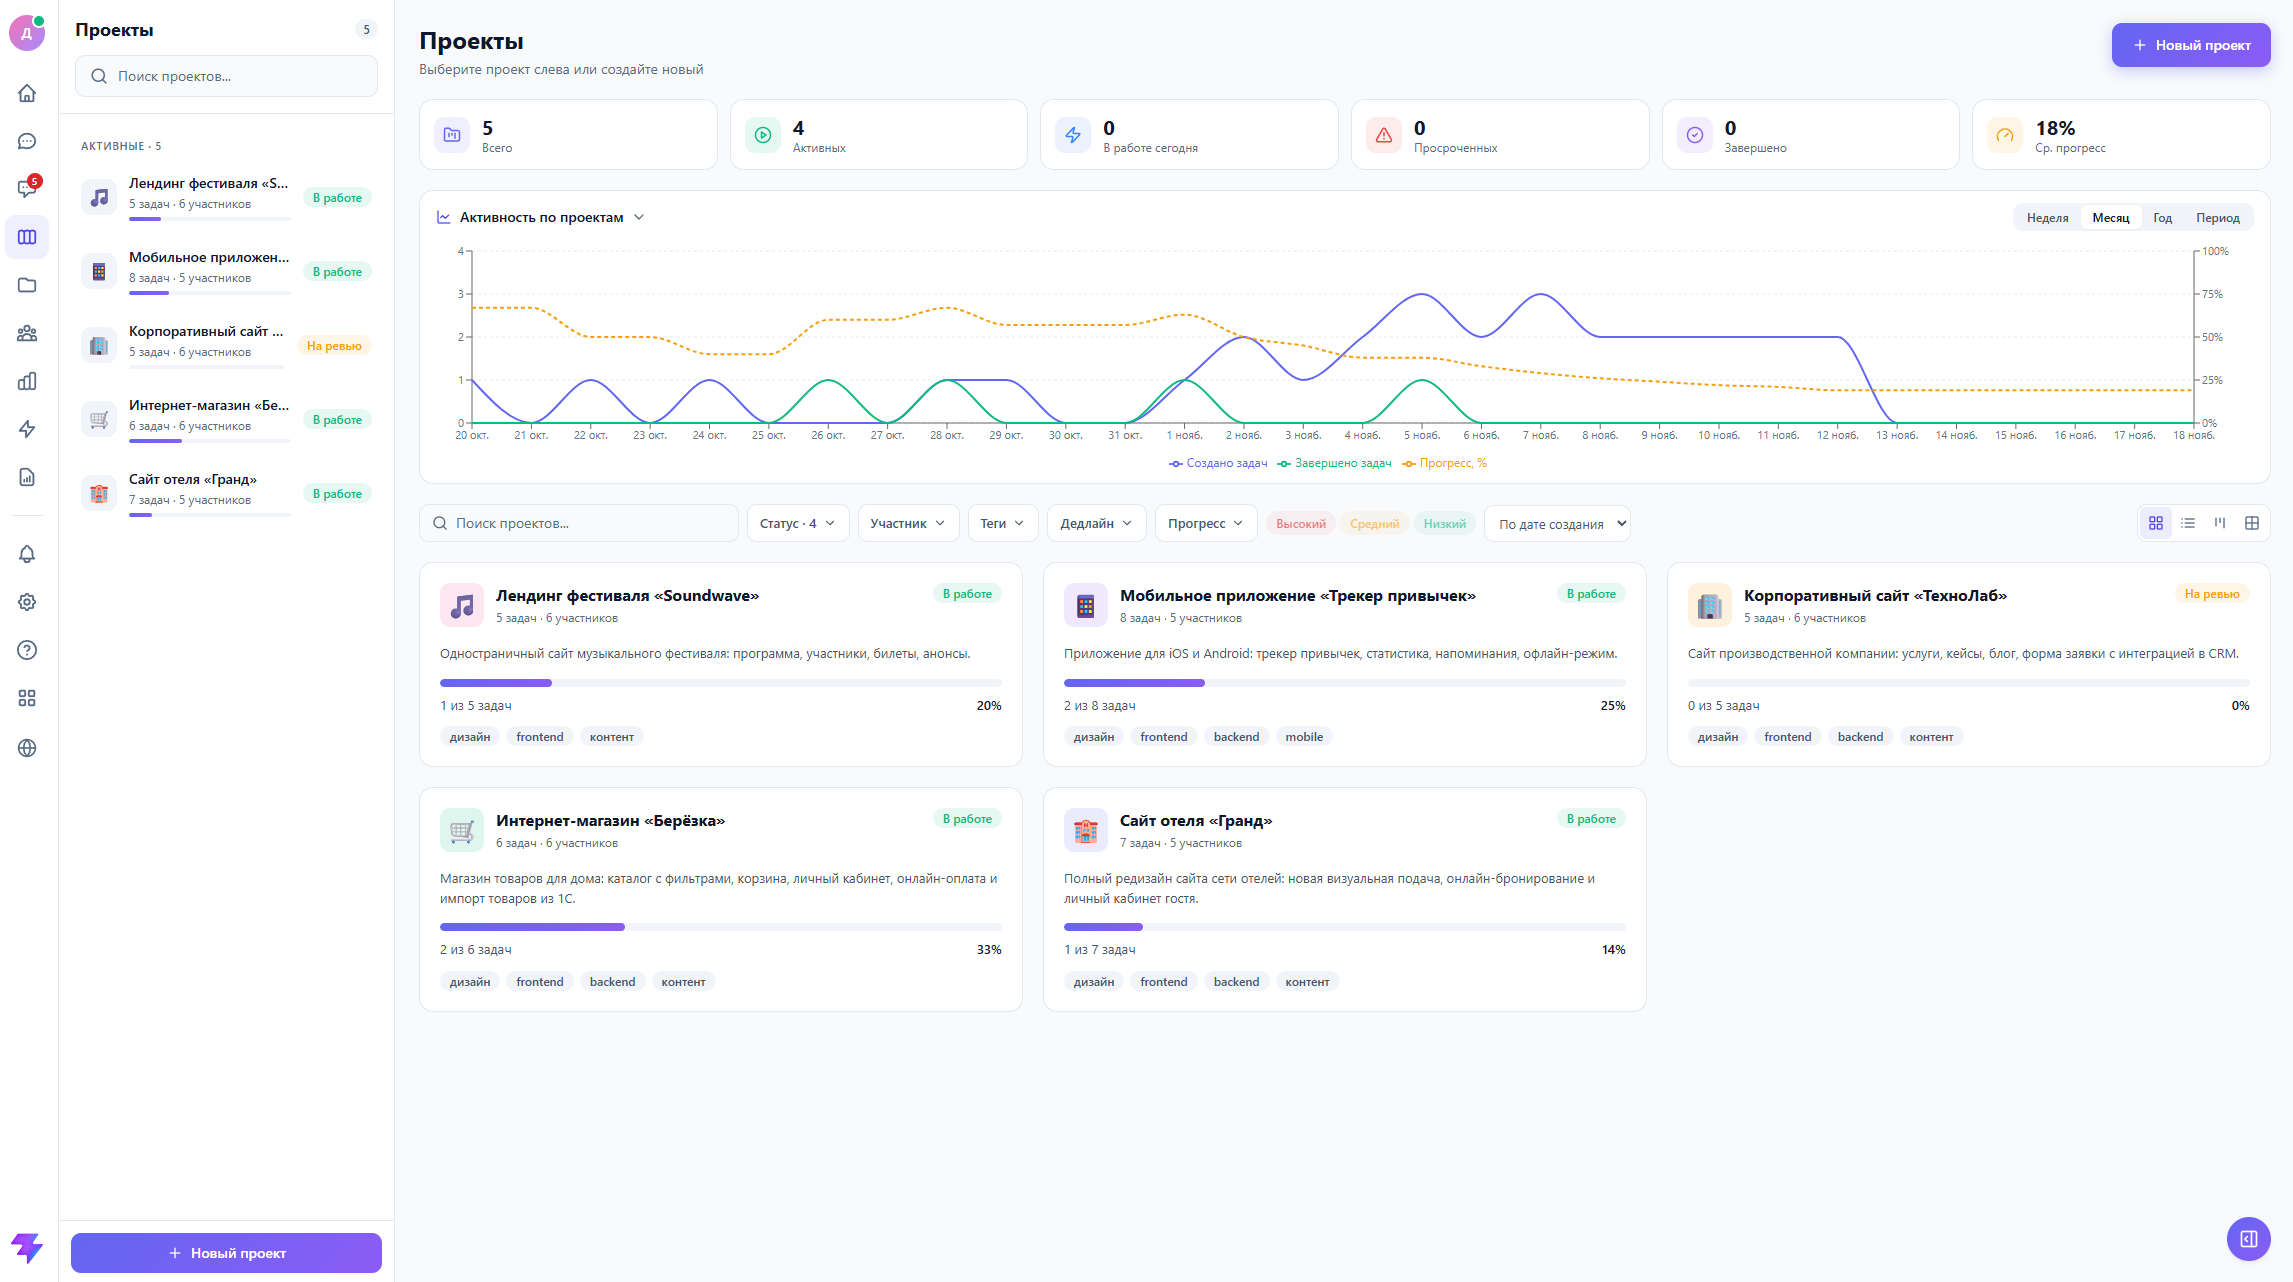
ЧОПТО — сервис для управления задачами и проектами в команде. Его основная идея проста: обсуждение не должно теряться отдельно от работы. Поэтому каждая задача становится небольшим рабочим пространством: в ней можно вести переписку по делу, прикреплять материалы и следить за ходом выполнения.
Вместо того чтобы переключаться между трекером, мессенджером и папкой с файлами, команда получает общий контекст в одном продукте. Задачи объединяются в проекты, у участников есть роли и зоны ответственности, а руководителю важно видеть не только отдельные поручения, но и общую картину работы. ЧОПТО задумывался как инструмент для команд, которым нужно проще договариваться, распределять задачи и доводить их до результата.
Это не попытка добавить ещё один список дел. Мне хотелось собрать вокруг задачи её обсуждение и необходимые рабочие сведения — так, чтобы человек мог быстро понять, что происходит и какой следующий шаг. По замыслу, такой подход должен подходить не только разработчикам: задачи и проекты есть у самых разных команд, от небольшого бизнеса до агентства или внутреннего отдела компании.
Важна и простота входа в работу: продукт должен помогать команде договориться о задаче и увидеть её движение, а не требовать сложной настройки прежде, чем появится первая польза. Это краткое описание идеи. Дальше в статье я расскажу, как постепенно переводил её в требования и технические решения.
Не один промт — а длинная цепочка решений
Когда рассказывают о разработке с искусственным интеллектом, разговор часто сводится к эффектной формуле: «Я написал один запрос — и получил готовый продукт». В реальной работе всё выглядит иначе. Продукт не появляется из одной фразы. Он складывается из множества решений: какую проблему решать, как должен выглядеть пользовательский сценарий, где проходят границы доступа, что произойдёт при ошибке и как убедиться, что очередное изменение не сломало соседнюю функцию.
ЧОПТО я разрабатывал один, в течение нескольких месяцев. Для всей работы использовал только сервис ПРОМТО на тарифе Про и режим «Безлимит» — нейрокредиты не расходовал. ИИ помогал мне анализировать задачи, продумывать решения, работать с кодом и проверять отдельные части продукта. Но именно я задавал направление, выбирал, что важнее, уточнял требования, оценивал результат и отвечал за продуктовые решения.
В этой статье я хочу рассказать не о волшебной кнопке и не о том, что теперь каждому достаточно одного удачного запроса. Мне интереснее показать сам процесс: как идея постепенно превращается в продукт, почему короткие и конкретные промты помогают лучше расплывчатых пожеланий, какие инженерные задачи оказались особенно сложными и чему меня научила работа с ИИ.
Я пишу для широкого круга читателей — предпринимателей, энтузиастов и программистов. Поэтому буду объяснять технические вещи через понятные задачи, а не через бесконечный перечень технологий. Названия и детали, которые могут раскрыть клиентские данные или внутреннюю инфраструктуру, здесь не используются.
Откуда выросла идея
Рабочая задача редко существует сама по себе. В ней есть постановка, ответственный, срок, уточнения, файлы, решения и история того, что уже произошло. Но в обычной работе всё это нередко разбросано по разным инструментам: сама задача находится в трекере, обсуждение — в мессенджере, файл — в облачном хранилище, а важная договорённость теряется где-то между ними.
Мне хотелось посмотреть на проблему иначе: а что, если обсуждение будет жить не рядом с задачей, а внутри её контекста? Не отдельный чат, который нужно ещё раз искать, а рабочая переписка, связанная с конкретным результатом.
Так появилась центральная идея ЧОПТО — «Задача как чат». Задача здесь не только строка в таблице со статусом. Это место, где можно понять, что нужно сделать, кто участвует, к какому сроку, какие шаги уже выполнены и о чём договорилась команда.
За этой формулой стоит более широкая идеология: рабочий инструмент должен помогать сохранять контекст. Если человек открывает задачу, ему важно увидеть не только её название, но и историю обсуждения, файлы, исполнителей, чек-лист и состояние работы. Чем меньше решений приходится восстанавливать по памяти и пересказам, тем легче команде двигаться дальше.
Это не означает, что любой продукт должен превратиться в комбайн. Наоборот, объединять стоит то, что действительно связано одним рабочим сценарием. Функция ценна не потому, что её можно добавить в список возможностей, а потому, что она помогает человеку сделать следующий шаг яснее.
Как идея становится требованиями
Первое искушение в разработке — сразу просить ИИ написать код. Но если не договориться, что именно мы строим, код быстро начинает отвечать на вопрос, которого никто толком не задавал.
Я разделял большую задумку на отдельные области: задачи и обсуждения, проекты, команда, права доступа, файлы, уведомления, аналитика, автоматизации и настройки. Для каждой области важны не только экраны, но и правила: кто может выполнить действие, какие данные должны сохраниться, что увидит пользователь при пустом состоянии или ошибке.
Документация помогала удерживать контекст. Бизнес-описание фиксировало идею и ценность продукта, техническое задание — общие ограничения и структуру, а модульные документы позволяли обсуждать отдельные части без необходимости каждый раз заново пересказывать весь проект.
Особенно полезны оказались пользовательские сценарии. Например, создание задачи — это не только форма с полями. Нужно учесть выбор проекта, назначение исполнителя, сохранение данных, появление задачи в нужном списке и уведомление заинтересованного участника. Такой сценарий даёт и человеку, и ИИ понятную последовательность, которую можно проверить.
Документация при этом не является доказательством, что всё описанное уже сделано. В большом проекте важно различать идею, план, текущую реализацию и то, что проверено в конкретном сценарии. Я старался относиться к требованиям как к карте, которую нужно сверять с фактическим поведением продукта.
Как был устроен мой рабочий цикл с ИИ
В основе работы лежала короткая петля обратной связи:
- Выбрать одну конкретную проблему или сценарий.
- Передать ИИ нужный контекст и границы задачи.
- Попросить сначала разобраться, если причина или правильное решение не очевидны.
- Внести ограниченное изменение.
- Проверить код и поведение: тестами, проверкой типов или воспроизведением сценария.
- Если результат не тот — описать разницу между ожидаемым и фактическим поведением и уточнить следующий шаг.
В этой схеме важны оба слова: «короткая» и «обратная связь». Большую задачу проще вести несколькими итерациями, чем одним запросом с десятком требований. Но короткий запрос не должен быть пустым. ИИ нужна информация, которая поможет понять цель, место работы и критерий успеха.
Иногда правильным первым действием было не изменение кода, а исследование. Если неясно, где формируется событие или какие проверки уже существуют, безопаснее попросить описать текущий поток и только потом выбирать исправление. Такой порядок снижает риск, что ИИ уверенно изменит не тот слой системы.
Мой режим работы был простым в описании, но требовал внимания: я ставил задачи, рассматривал предложения, принимал или отклонял решения, проверял результат и продолжал следующую итерацию. ИИ мог ускорить анализ и работу с кодом, но не мог автоматически знать, какой компромисс подходит продукту и какие последствия приемлемы.
На протяжении разработки я пользовался ПРОМТО на тарифе Про и режимом «Безлимит», не расходуя нейрокредиты. Это важная часть моего опыта: я мог организовать работу именно в этих условиях. Но из этого не следует, что у всех тарифов, режимов и правил сервиса всегда одинаковые условия — перед публикацией подобные сведения стоит сверять с актуальными условиями.
Один интерфейс — несколько слоёв контекста
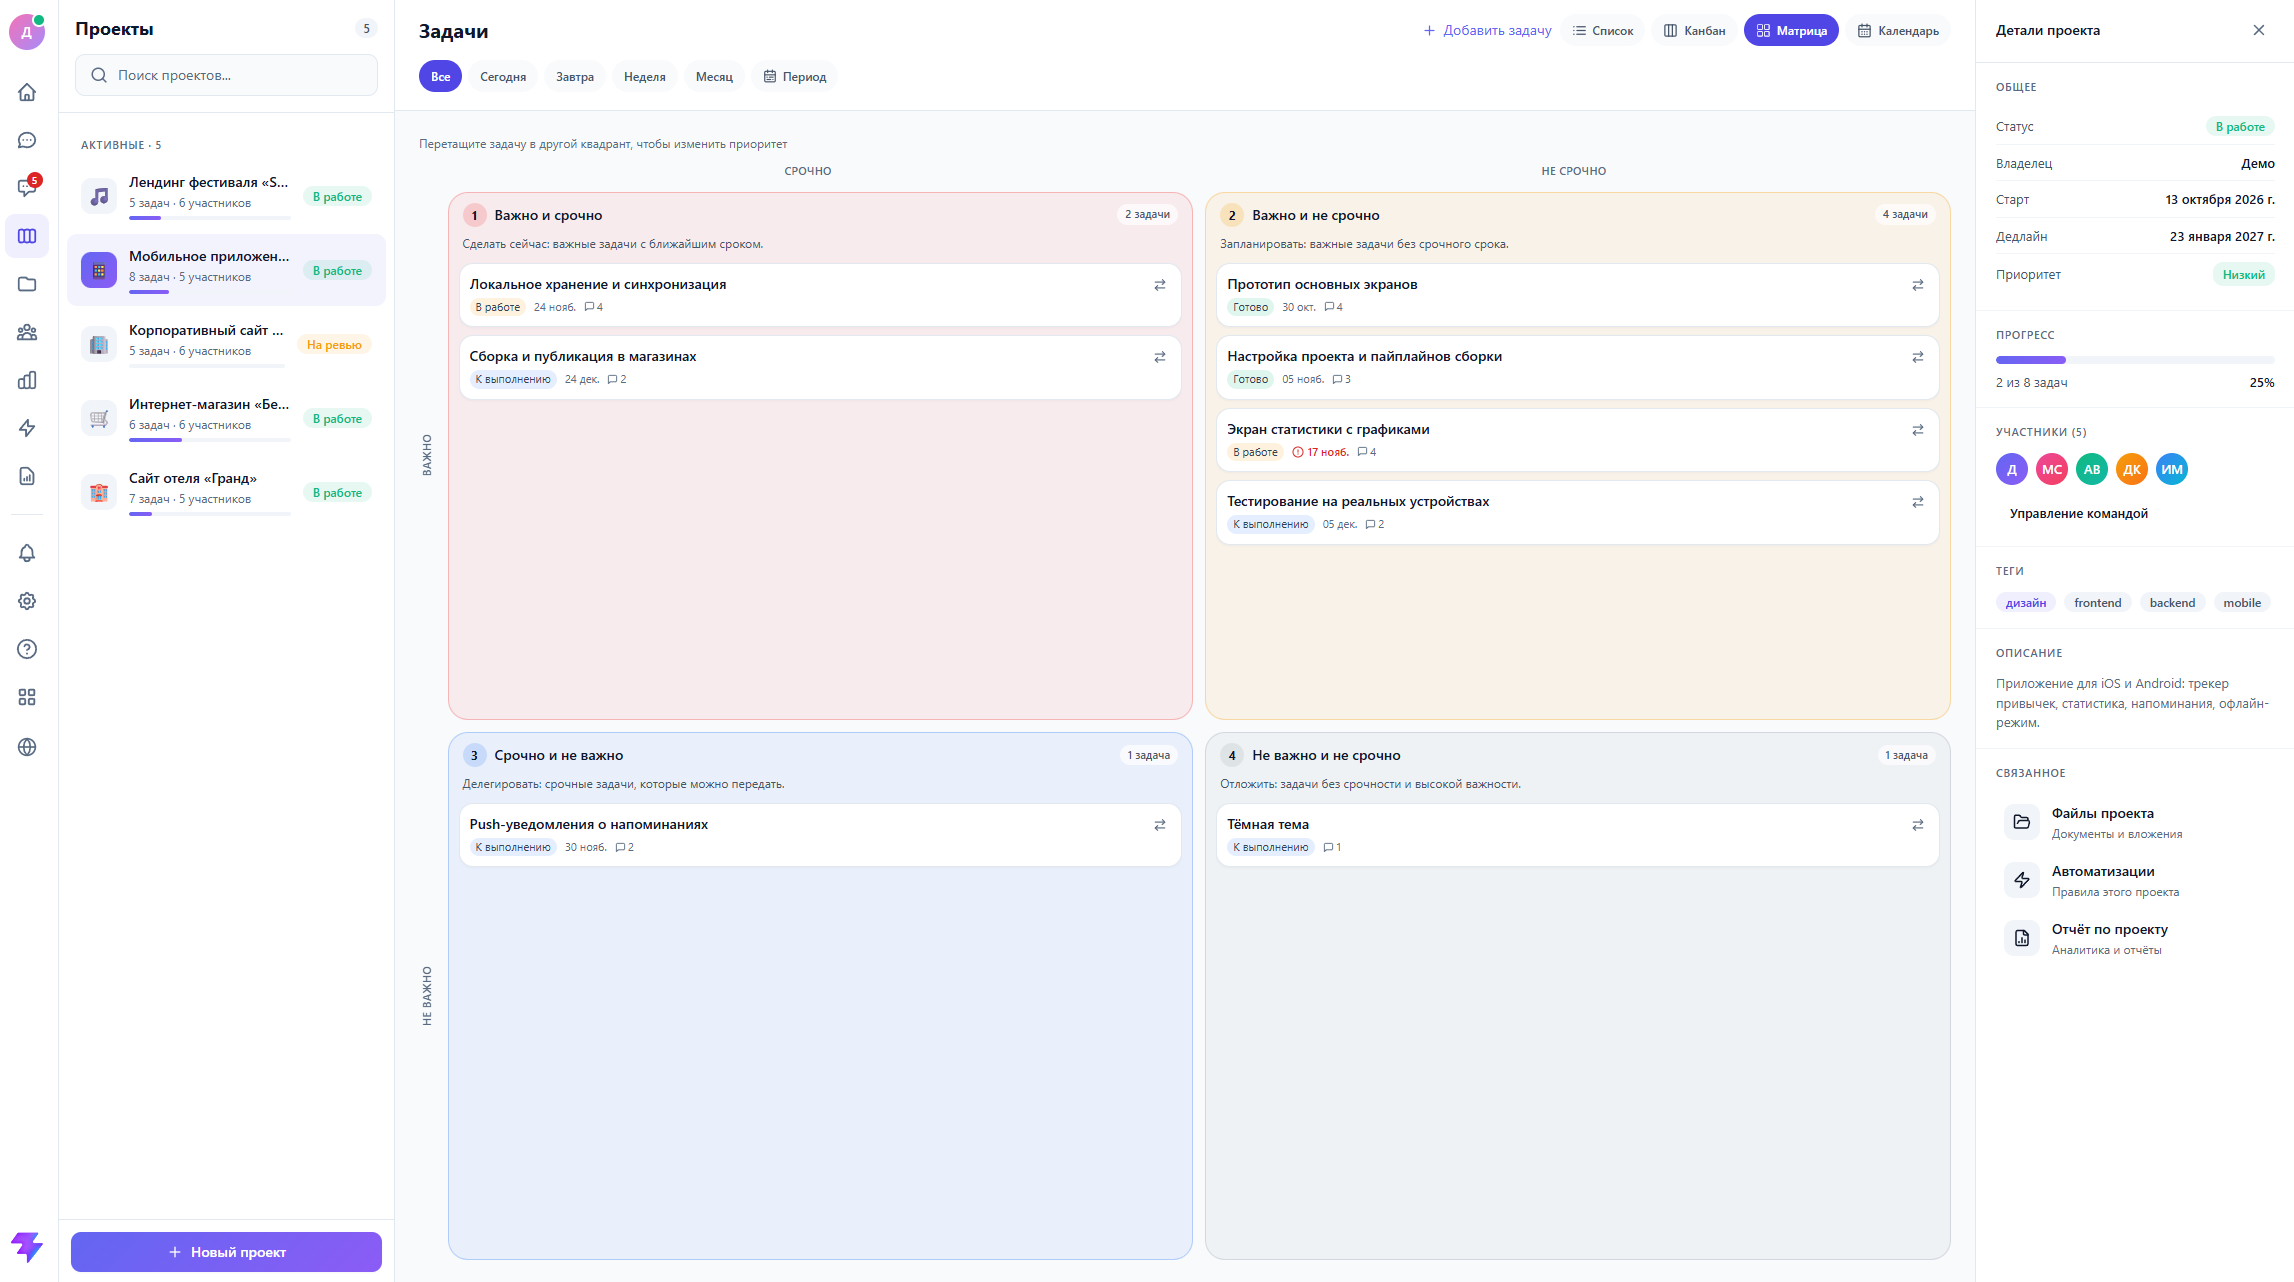
Идея «Задача как чат» должна быть видна не только в описании продукта. Она проявляется в том, как устроен экран: пользователь перемещается между рабочими областями, списком задач, содержимым выбранной задачи и деталями, которые помогают действовать.
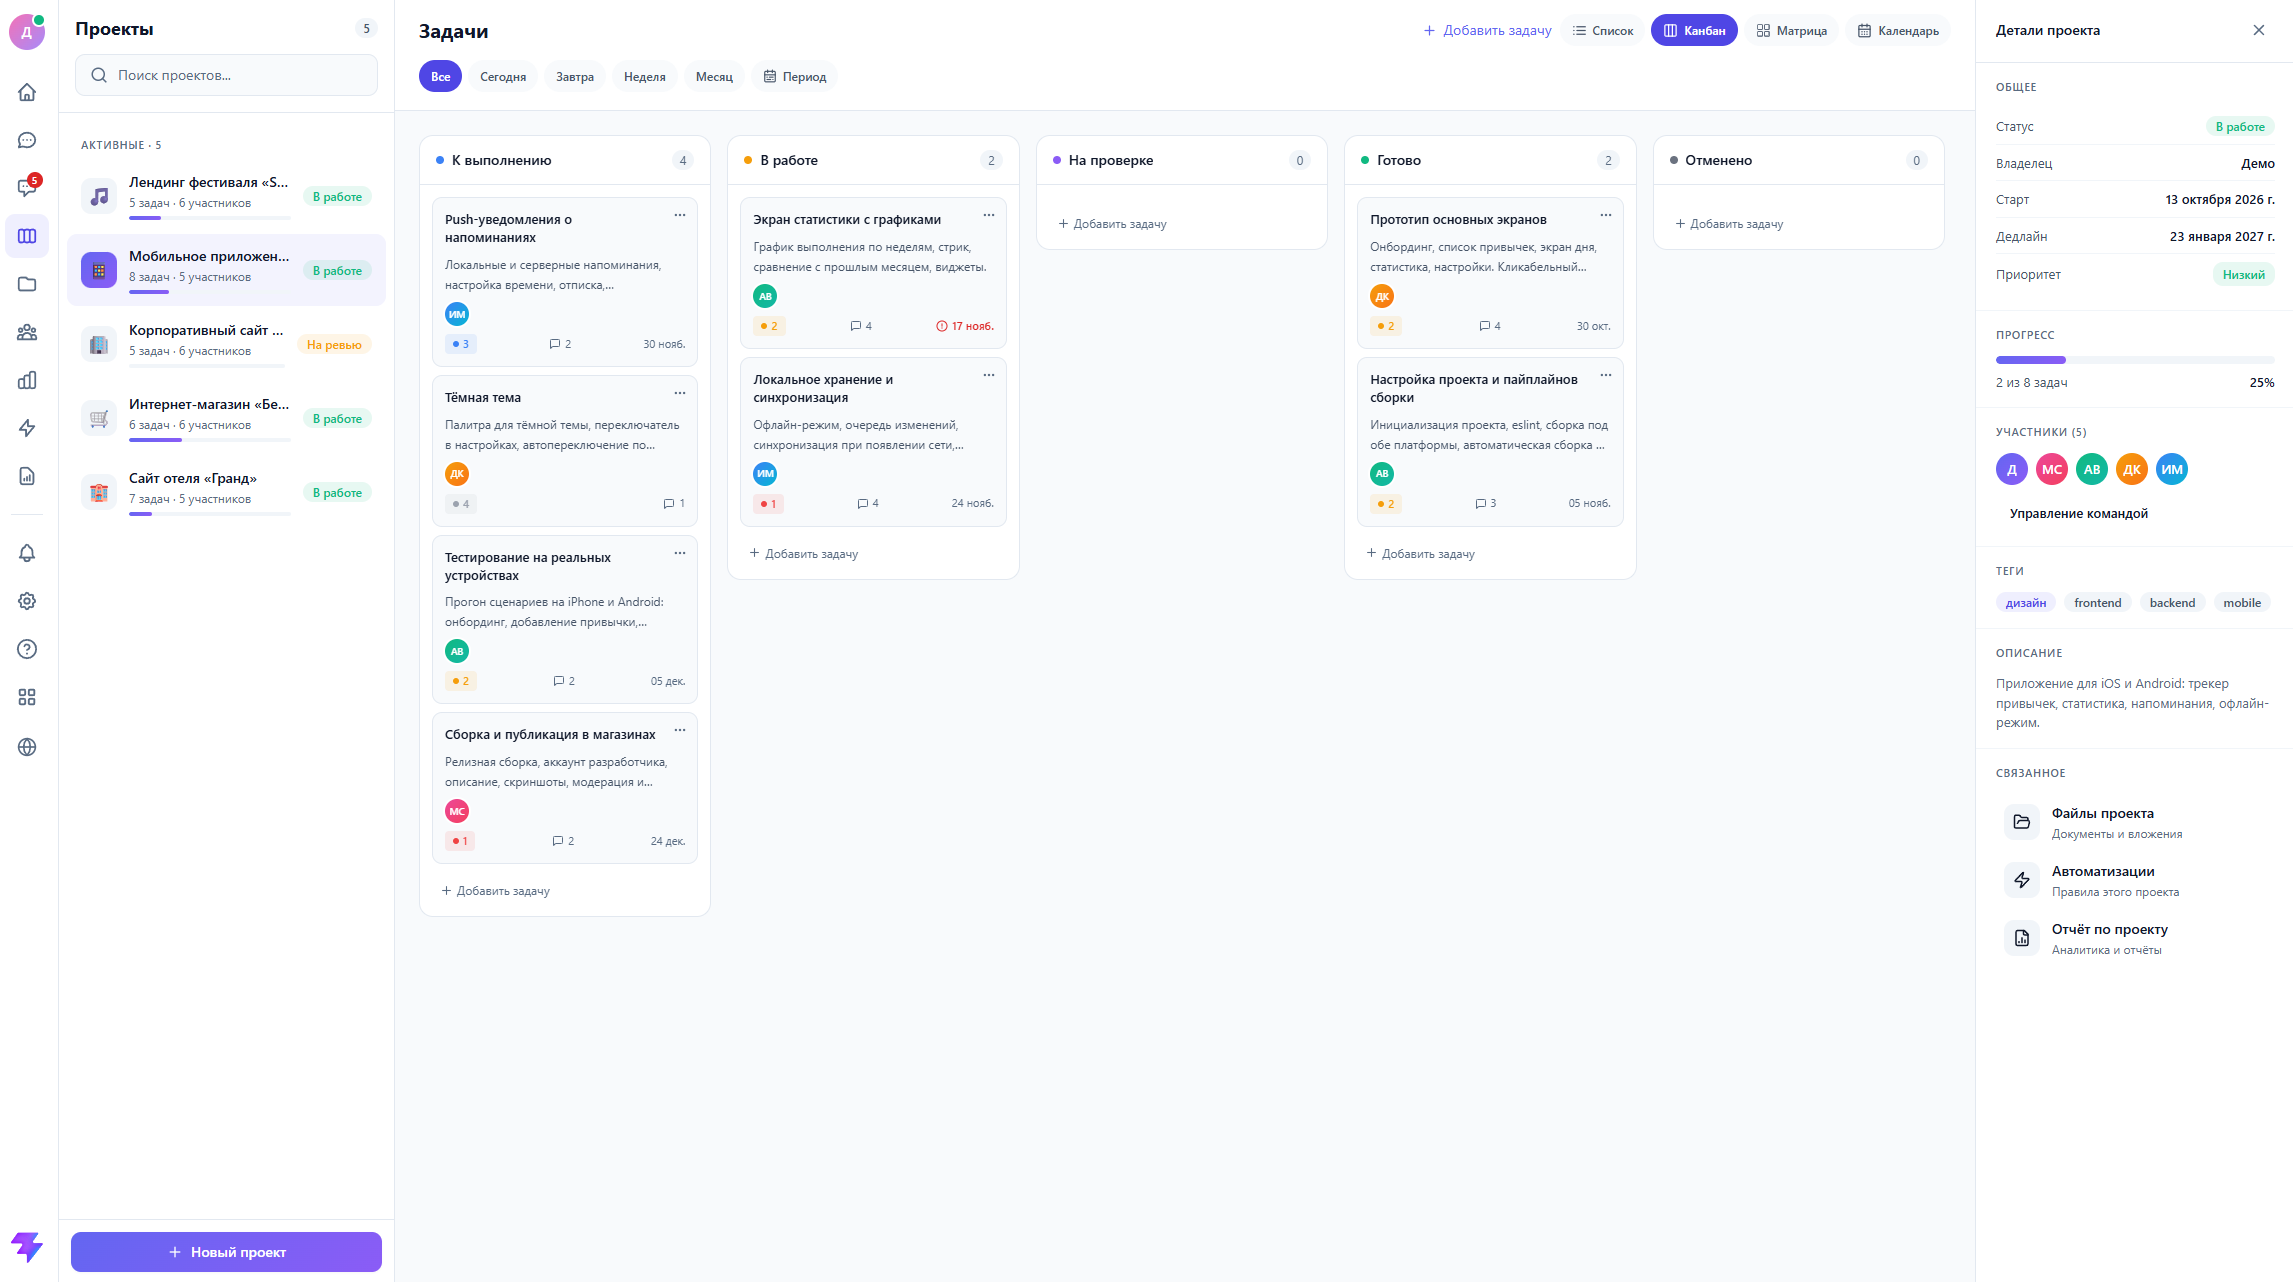
В одной ситуации удобнее видеть задачи списком, в другой — перемещать карточки по колонкам канбана, в третьей — сравнивать значения в таблице. Представления отвечают на разные вопросы. Канбан помогает заметить движение работы по статусам; список удобен для последовательного просмотра; таблица может оказаться полезной, когда нужно сопоставить много полей.
Когда пользователь выбирает задачу, ему важны и разговор, и факты о работе. Поэтому обсуждение должно соседствовать с деталями: исполнителями, сроком, приоритетом, чек-листом, вложениями и активностью. Интерфейс не должен заставлять каждый раз уходить в другое место, чтобы узнать, о чём договорились и что осталось выполнить.
Разработка интерфейса — это не только идеальное состояние на широком экране. Нужны пустые списки, ошибки, загрузка, отсутствие прав, мобильная ширина и ситуации, когда данные меняются. Если команда не создала ни одной задачи, экран должен помочь начать, а не выглядеть как сломанная страница. Если действие недоступно, это должно быть понятно пользователю, но сама проверка права обязана происходить не только в интерфейсе.
Архитектура: объяснить просто, не упрощая чрезмерно
ЧОПТО построен как приложение на Next.js и TypeScript. Если объяснить общий путь запроса без погружения в детали: браузер обращается к серверной части приложения, обработчик передаёт работу сервисному слою, а тот применяет бизнес-правила и работает с PostgreSQL через слой доступа к данным.
Такое разделение похоже на распределение обязанностей в небольшой команде. Обработчик принимает запрос и отвечает за протокол взаимодействия. Сервис знает правила предметной области. Слой базы данных отвечает за чтение и изменение сохранённых данных. Когда эти роли смешиваются в одном месте, систему сложнее проверять и безопасно развивать.
TypeScript помогает раньше замечать часть несоответствий в коде, а схемы валидации позволяют проверять входящие данные. Это не делает программу автоматически безошибочной, но добавляет дополнительные барьеры против некорректного ввода и случайных изменений.
Для постоянных данных используется PostgreSQL. Для разработчика база — не просто место, где лежат записи: в ней отражаются связи между задачами, сообщениями, участниками и рабочими пространствами. Изменение модели часто затрагивает не один экран, поэтому схему данных и миграции нужно рассматривать осторожно.
Есть и работа, которая не должна зависеть от открытой страницы: периодические напоминания, повторная обработка некоторых событий, фоновые операции. Для таких задач нужен отдельный фоновый процесс. Это похоже на разницу между кассой, которая обслуживает человека прямо сейчас, и служебной работой, которую система выполняет самостоятельно по расписанию или по очереди.
Из этого не следует, что один репозиторий означает маленькую систему. В одной кодовой базе может находиться много модулей, правил, интерфейсов и фоновых сценариев. Простота развёртывания и сложность предметной области — разные характеристики.
Realtime: обновления должны быть быстрыми, а данные — надёжными
Когда коллега отправил сообщение или изменил статус задачи, хочется увидеть это почти сразу. Но сложность здесь не в том, чтобы «открыть постоянное соединение». Нужно одновременно решить три задачи: не потерять событие при сбое, не раздавать его не той команде и не расходовать соединение с базой на каждую открытую страницу.
Самый сложный случай: изменение записано, а уведомление не дошло
Если сначала сохранить задачу, а отдельным запросом после этого отправить уведомление, между этими действиями может произойти сбой. В базе изменение уже есть, но подписчики о нём не узнали. Обратный порядок тоже опасен: клиент получил сигнал об изменении, которое затем не удалось сохранить.
Для доменных событий в ЧОПТО используется transactional outbox — таблица исходящих событий. Событие записывается в той же транзакции, что и изменение предметных данных; фоновый worker затем публикует его. Схематично это выглядит так:
await db.$transaction(async (tx) => {
  const task = await tx.task.update({
    where: { id: taskId },
    data: { status: nextStatus },
  });

  await emitDomainEvent({
    workspaceId,
    type: "task.status_changed",
    aggregateType: "task",
    aggregateId: task.id,
    payload: { status: task.status },
  }, tx);
});
Ключевой здесь не синтаксис, а передача tx: изменение задачи и запись в outbox коммитятся вместе. Если транзакция откатится, не останется и ложного события; если коммит прошёл, worker сможет найти событие и доставить его дальше. Сам worker публикует уведомление через PostgreSQL NOTIFY, а web-процесс слушает канал LISTEN.
Это не делает сеть безошибочной, но разделяет надёжность и скорость: база хранит факт, outbox сохраняет намерение уведомить, а realtime-канал ускоряет обновление интерфейса. Для временных сигналов вроде «печатает» или присутствия применяется отдельный эфемерный канал: такие сведения не нужно превращать в постоянную историю.
Переподключение и пропущенный участок событий
Долгое соединение может оборваться. Если просто подключиться заново и продолжить, между разрывом и восстановлением пользователь мог пропустить несколько событий. Поэтому у SSE-событий есть идентификаторы, а клиент может передать последний полученный ID. Сервер пробует дочитать ограниченный хвост из outbox; если пропуск слишком старый или слишком большой, отправляет resync, чтобы клиент запросил актуальное состояние обычным способом.
Упрощённый фрагмент проверки границы выглядит так:
if (!last || last.createdAt < since) {
  send("resync", { reason: "gap_too_old" });
  return false;
}

const rows = await outbox.findMany({
  where: { id: { gt: lastId }, workspaceId },
  orderBy: { id: "asc" },
  take: BACKFILL_LIMIT + 1,
});

if (rows.length > BACKFILL_LIMIT) {
  send("resync", { reason: "gap_too_large" });
  return false;
}
Здесь важны ограничение окна и лимит размера: бесконечно воспроизводить историю нельзя. Если восстановление становится слишком дорогим или неоднозначным, безопаснее синхронизировать экран с сервером заново, чем делать вид, что клиент получил непрерывную последовательность.
Как не умножить подключения на количество пространств
Пока события читаются из общей базы, web-процессу достаточно слушать её каналы. Но при раздельных базах рабочих пространств появляется новый риск: если каждая реплика web откроет LISTEN к каждой tenant-базе, число соединений вырастет примерно как «число пространств × число реплик приложения».
Для этого предусмотрен релей событий в общей базе. Когда событие пришло из отдельной tenant-базы, приложение публикует его через пул ограниченного размера; web-процессы слушают общий брокер, а маршрутизируют событие подписчикам по workspaceId. Так число слушающих соединений не должно расти линейно с числом пространств.
В коде развилка намеренно небольшая:
if (shouldUseRelay(sourceDatabaseUrl)) {
  await publishViaRelay(event, body);
  return;
}

await tx.$executeRaw`SELECT pg_notify(${EVENTS_CHANNEL}, ${body})`;
То есть общий переходный режим сохраняет публикацию внутри исходной транзакции, а отдельный источник использует релей. В самом реле есть настраиваемый предел RELAY_MAX_CONNECTIONS: если все соединения заняты, новая публикация ждёт освобождения, а не открывает бесконечное число подключений.
Изоляция подписок и обратная доставка
Быстро доставить событие — недостаточно; оно должно попасть только тем, кому положено. Перед отправкой hub сверяет контекст подписчика и workspaceId события, затем учитывает аудиторию — например, адресовано ли сообщение конкретным пользователям. Схематично:
try {
  assertTenantSubscription(subscriber, { workspaceId: event.workspaceId });
} catch {
  return false; // чужое пространство не получает событие
}

if (audience.userIds?.length) {
  return audience.userIds.includes(subscriber.userId);
}
return true;
Это важный узкий участок: ошибка фильтрации realtime — не просто баг интерфейса, а потенциальное раскрытие чужих данных. Поэтому область подписки проверяется отдельно от факта авторизации.
На уровне ресурсов также есть пределы: ограничивается число SSE-подписчиков на процесс и число подключений одного пользователя. При превышении лимита старое соединение пользователя закрывается с сигналом о переподключении, а процессный предел не даёт принять бесконечное число потоков. В результате realtime здесь — это не одна технология, а связка outbox, транзакций, ограниченного релея, backfill, повторной синхронизации и фильтрации по рабочему пространству.
Для пользователя всё это выглядит просто: сообщение появилось, карточка переместилась, уведомление обновилось. Но за этой простотой находятся именно те случаи, где приходится выбирать между скоростью, целостностью данных, изоляцией и ограниченными ресурсами.
Изоляция рабочих пространств — сложная граница системы
Одна из наиболее непростых тем в проекте — разделение данных команд. Рабочее пространство (workspace) — область, к которой принадлежат свои проекты, задачи, участники, файлы и настройки. Пользователь может состоять в нескольких пространствах, но данные разных команд должны оставаться разделёнными.
На раннем этапе общей базы проще придерживаться: таблицы находятся рядом, а связи между ними задаются внешними ключами. Но если пространство получает отдельное размещение, привычное предположение перестаёт работать. Identity — глобальная учётная запись пользователя и его сессия; tenant-данные — задачи, проекты и участники конкретной команды. Между разными базами уже нельзя полагаться на один общий SQL-внешний ключ. Приложение должно явно определить, какой контекст оно проверяет и куда направляет запрос.
Самая опасная ситуация: каталог говорит «да», tenant говорит «нет»
В системе с несколькими рабочими пространствами центральный каталог может помогать найти кандидатов: в каких командах пользователь числится. Но если каталог отстаёт или опережает данные самой команды, он не должен сам по себе расширять доступ. Источник истины о членстве и роли должен быть подтверждён в tenant-контексте.
В резолвере сначала проверяется наличие активного членства, затем согласованность идентификатора размещения, и для отдельной tenant-базы выполняется дополнительная проверка членства уже в ней:
const membership = await memberships.findActive(userId, workspaceId);
if (!membership || membership.workspaceId !== workspaceId) {
  throw new TenantResolutionError("MEMBERSHIP_REQUIRED");
}

const locator = await this.locator(workspaceId, placement);
if (locator.placementId !== placement) {
  throw new TenantResolutionError("PLACEMENT_UNAVAILABLE");
}

const tenantMembership = await db.workspaceMember.findFirst({
  where: { userId, workspaceId, status: "active" },
  select: { role: true },
});
if (!tenantMembership) {
  throw new TenantResolutionError("MEMBERSHIP_REQUIRED");
}
Смысл этой последовательности — не доверять одному указателю. Каталог помогает найти данные, но подключение к базе не считается доказательством права. Если подтверждения нет, запрос останавливается. В документации проекта также описано dual-read-сравнение центрального каталога с каноническим членством: расхождение фиксируется для диагностики, но переходная проверка не должна молча выдавать каталог за источник истины.
Это особенно важно после резервного восстановления. Если identity и tenant-база восстановлены к разным моментам времени, каталог может содержать уже отозванное членство или не знать о действующем. Безопасное поведение — не расширять доступ по устаревшей проекции; сначала сверить состояние с tenant-источником и восстановить согласованность.
Вторая сложная ситуация: старое размещение продолжает принимать запись
При переносе пространства на другую базу некоторое время существуют старое и новое размещения. Старые соединения ещё могут быть открыты, а часть экземпляров приложения могла получить прежнюю информацию о маршруте. Если обе базы продолжают принимать изменения, данные расходятся: новые сообщения или задачи могут появиться только на одной стороне.
Для этого нужны два связанных механизма. Окно read-only временно запрещает запись, пока выполняются финальная синхронизация и переключение. Fencing отсекает запись в размещение, которое уже перестало быть основным. Проверка устроена закрытым образом: если журнал переключений недоступен, приложение не трактует это как разрешение.
Упрощённая логика решения выглядит так:
let switches;
try {
  switches = await db.placementSwitch.findMany({
    where: { workspaceId },
    orderBy: { switchedAt: "desc" },
  });
} catch {
  return { fenced: true, reason: "unknown" };
}

const movedAway = switches.find(
  (item) => item.fromPlacementId === placementId && !item.revertedAt,
);
if (movedAway) {
  return { fenced: true, reason: "switched_away" };
}
В человеческом переводе: если система не может доказать, что эта база всё ещё основная, запись в неё блокируется. Это может временно ограничить действие пользователя, зато предотвращает более серьёзный риск — незаметную двойную запись.
Перенос — последовательность с контрольными точками, а не копирование
Безопасный перенос разбит на этапы: выбрать и зарезервировать целевое размещение, выполнить начальное копирование, догнать новые изменения, открыть окно только для чтения, провести финальную синхронизацию, сверить результат и лишь затем атомарно переключить маршрутизацию.
В проверке учитываются не только строки таблиц, но и связанные файлы и служебные состояния. Для файлов важны контрольные суммы SHA-256; для базы — сверка количества записей и момента последнего изменения. Если контроль не прошёл, переключение не должно происходить.
Каждый этап записывается в журнал. Это решает два сложных случая: процесс может оборваться посередине, а повторный запуск не должен повторно выполнять уже завершённое переключение. Журнал позволяет продолжить с последней безопасной точки, а ограниченное окно отката задаёт порядок возврата, если после переключения обнаружилась проблема.
Упрощённо последовательность можно представить так:
for (const stage of PLACEMENT_MOVE_STAGES) {
  if (await journal.isCompleted(moveId, stage)) continue;

  await journal.beginStage(moveId, stage);
  try {
    const detail = await adapters[stage](context);
    await journal.succeedStage(moveId, stage, detail);
  } catch (error) {
    await journal.failStage(moveId, stage, String(error));
    throw error;
  }
}
Это схема идеи, а не дословный листинг проекта: фактические адаптеры и типы этапов специфичны. В реализации порядок этапов и правила возобновления отделены от деталей работы с базами и файловым хранилищем — так легче проверять саму процедуру и её поведение при сбоях.
Как сделать отказ безопасным и понятным
Правило fail-closed применяется и к окну переноса: если журнал недоступен или не удалось подтвердить состояние операции, запись временно блокируется. Такой ответ неудобнее оптимистичного «наверное, можно», зато не позволяет неопределённости превратиться в повреждение данных.
Но у этого подхода есть граница: проверка должна стоять на всех значимых точках записи. Документация проекта прямо отмечает, что подключение блокировки ещё не охватывает каждую возможную операцию изменения. Поэтому я описываю механизм как важное инженерное решение, а не объявляю весь путь миграции безусловно завершённым.
Для маршрутизации запросов используется резолвер, для повторно используемых соединений — ограниченный пул, для изменений между системами — журналируемые этапы, а для безопасного отказа — fail-closed-проверки. Вместе эти решения превращают перенос из рискованной разовой команды в контролируемый процесс с точками проверки и восстановления.
Здесь важно не путать архитектурную цель с завершённой миграцией. В документации проекта некоторые этапы описаны как частичные, целевые или требующие дальнейшей проверки. Поэтому в статье технический рассказ показывает реальные механизмы и их границы, но не утверждает, что каждый сценарий изоляции и переноса уже полностью завершён и подтверждён.
Безопасность — это не спрятанная кнопка
Пользователь может быть авторизован, но это ещё не означает, что ему разрешено любое действие. Нужно проверить, состоит ли он в нужном рабочем пространстве, какую роль имеет и относится ли запрошенный объект к области его доступа.
Роли помогают распределять ответственность: владелец и администратор управляют пространством, менеджер организует работу, участник выполняет задачи, зритель получает ограниченный доступ. Конкретные возможности роли нужно задавать правилами, а не полагаться на название.
Скрытая кнопка не является защитой. Пользователь может отправить запрос не через интерфейс, поэтому сервер обязан проверить право на самой границе API и в нужной бизнес-логике. Точно так же важно продумывать истёкшие приглашения, удалённых участников, завершившиеся сессии и запросы без необходимого контекста.
Безопасность складывается из нескольких уровней: аутентификации, проверки полномочий, изоляции данных, валидации, аудита и аккуратной обработки ошибок. Если один уровень ошибся, остальные должны помогать ограничить последствия.
Примеры промтов, которыми можно пользоваться
Хороший промт не обязан быть длинным. Но в нём желательно обозначить четыре вещи: контекст, цель, границу изменения и проверку результата. Ниже — синтетические примеры для типичных задач разработки. Они не содержат клиентских данных или внутренних адресов.
1. Сначала разобраться, потом менять
Разбери сценарий приглашения участника: опиши текущий поток и места проверки срока действия токена. Пока не меняй код.
Такой запрос полезен, когда причина проблемы неясна. Он просит сначала построить картину, а не начинать с догадки.
2. Ограниченная правка интерфейса
В карточке задачи покажи дедлайн рядом со статусом. Сохрани адаптивность и проверь тесты компонента.
Здесь названы нужное изменение, важное ограничение и один критерий проверки.
3. Проверить доступ между командами
Проверь, что участник другого workspace не может читать эту задачу. Найди серверную проверку и добавь тест на отказ.
Ценность промта в том, что он говорит о безопасности на сервере, а не только о том, что элемент нужно скрыть в интерфейсе.
4. Добавить тест, не меняя соседнее поведение
Добавь unit-тест для пустого списка исполнителей. Не меняй поведение остальных фильтров.
Это маленькая задача с понятной границей. Если тест обнаружит проблему в коде, следующий шаг можно обсуждать отдельно.
5. Проследить realtime-событие
Проследи смену статуса от записи в базе до обновления клиента. Сначала опиши цепочку, затем предложи минимальную правку.
Запрос помогает не перескакивать к исправлению, не понимая, где именно теряется событие.
6. Проверить перенос данных
Сверь экспорт и импорт workspace: перечисли связанные сущности, которые не переносятся. Пока ничего не исправляй.
Сначала инвентаризация, затем решение. Для миграций такой порядок особенно важен: ошибка может затронуть много связанных записей.
7. Исправить конкретное сообщение
Исправь текст ошибки для истёкшего приглашения. Не меняй формат API и добавь проверку сценария.
Здесь ограничено не только желаемое действие, но и то, что должно остаться неизменным.
8. Найти проблему адаптивности
На мобильной ширине панель деталей перекрывает список. Найди причину, сохрани desktop-поведение и проверь оба размера.
Промт описывает наблюдаемое поведение и просит проверить две области, а не просто «сделать мобильную версию лучше».
Общая закономерность: вместо «сделай правильно» лучше назвать сценарий и ожидаемое поведение. Если есть риск затронуть важные данные или права, сначала просить анализ и план проверки. А после выполнения всё равно нужно посмотреть, что изменилось: промт — это постановка задачи, не гарантия качества результата.
Проверка результата — часть разработки
ИИ может неправильно понять контекст, выбрать не тот слой приложения, забыть граничный случай или предложить слишком широкую переделку. Поэтому у меня был важный принцип: не принимать ответ как готовый только потому, что он выглядит убедительно.
Проверка зависит от задачи. Для логики полезны unit-тесты и проверки типов; для взаимодействия нескольких компонентов — интеграционные тесты; для интерфейса — воспроизведение сценария и оценка поведения на подходящих размерах. Если меняются права доступа, нужно проверять именно отказ для неподходящего пользователя. Если меняется миграция — рассматривать целостность данных и возможность безопасного восстановления.
Когда результат не совпадает с ожиданием, полезнее сообщить конкретную разницу: что я сделал, что ожидал увидеть и что произошло вместо этого. Затем стоит локализовать причину и внести ограниченное изменение. Так обратная связь помогает продвигаться, а не превращается в серию случайных переписываний.
Скорость генерации кода и скорость получения надёжной функции — не одно и то же. Выигрыш даёт не только быстрое создание фрагмента, но и короткий цикл, в котором проблему можно уточнить, проверить и исправить до того, как она разрастётся.
Что значит «я сделал продукт один»
Когда я говорю, что ЧОПТО делал один человек, я имею в виду авторство продукта и организацию разработки: я определял замысел и приоритеты, формулировал требования, выбирал решения, проверял поведение и принимал ответственность за результат. Это не значит, что каждую строку кода я набирал вручную без инструментов. ИИ был частью моего рабочего процесса и помогал с анализом и реализацией.
Но инструмент и автор — не одно и то же. ИИ не несёт ответственность перед пользователями, не выбирает за меня, какую проблему стоит решать, и не знает автоматически, какой компромисс будет приемлем для бизнеса. Чем больше возможностей у инструмента, тем важнее умение точно определить задачу и не отпускать проверку результата.
Соло-разработка не доказывает, что любую команду можно заменить одним человеком. Она показывает другой вариант организации работы: один автор может использовать ИИ, чтобы справляться с большим количеством инженерных задач, сохраняя за собой продуктовые решения и контроль.
Что я вынес из этих месяцев
Первое: большая идея становится продуктом не одним рывком, а серией проверяемых шагов. Второе: постановка задачи — это часть разработки. Третье: ИИ полезнее всего, когда видит нужный контекст, понимает границы изменения и знает, как будет оцениваться результат.
Я также убедился, что документация не заменяет проверку кода, а код не заменяет проверку пользовательского сценария. Для сложной системы важны не только новые функции, но и роли, ошибки, миграции, восстановление, реальные ограничения инфраструктуры и ясное понимание того, что уже сделано, а что ещё остаётся планом.
Режим «Безлимит» и тариф Про были теми условиями, в которых я работал над ЧОПТО, не расходуя нейрокредиты. Но ни один тариф не отменяет ограничений времени и внимания. Можно быстрее получить варианты и провести больше итераций, но всё равно нужно думать, сравнивать, проверять и принимать решения.
ЧОПТО для меня — это прежде всего попытка собрать задачу и её контекст в одном месте. А сам процесс разработки стал примером того, как один человек может работать с ИИ не вместо мышления, а через мышление: задавать точные вопросы, строить систему по частям и отвечать за то, что в итоге увидит пользователь.
Я бы начал разговор о разработке с ИИ не с вопроса «какой промт всё построит?», а с другого: «какую конкретную проблему я могу описать и проверить следующим шагом?» Именно из таких шагов и складывается продукт.
Если у есть желание пообщаться или обсудить проект, пишите мне в Промто или на Email: info@magonov.pro